 EN
Datensouveränität
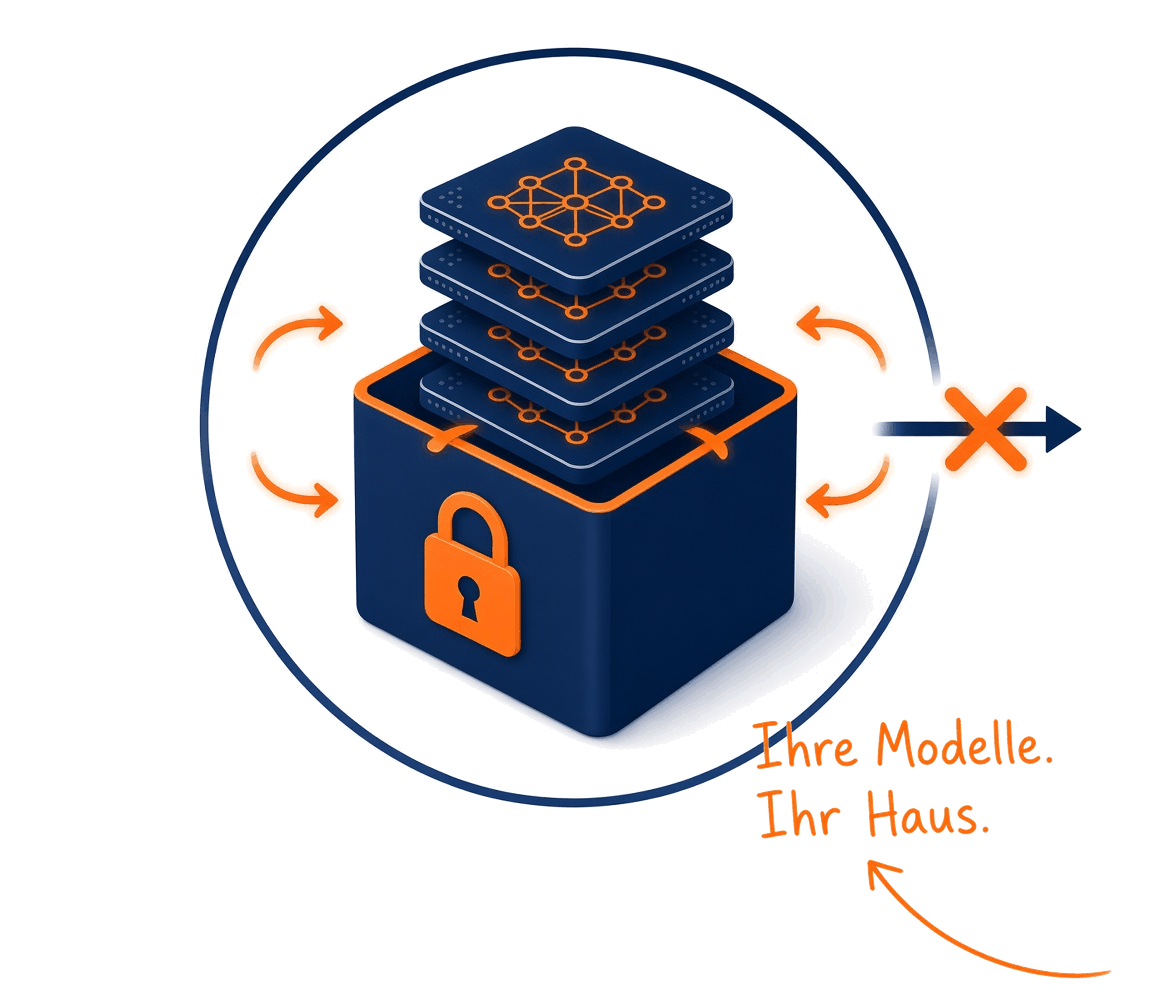
Alle Modelle laufen auf der Appliance in Ihrem Haus. Ohne externe Modell-API verlässt keine Eingabe und kein Dokument Ihr Netz.
Lokale Modelle
souveraen.ai betreibt seine Sprachmodelle vollständig auf Ihrer eigenen Hardware: offene Gewichte, festgeschriebene Versionen, keine externe Modell-API. Keine Eingabe und kein Dokument verlässt Ihr Haus.
 Modelle mit offenen GewichtenKeine externe Modell-API
 Fester monatlicher Preis
So kommt ein Modell auf die Appliance
Kein Modell wird aus dem Internet nachgeladen. Jedes durchläuft zuvor denselben Weg.
Nur Modelle mit offenen Gewichten und einer Lizenz, die kommerzielle Nutzung erlaubt.
Qualität, Geschwindigkeit und Speicherbedarf werden auf der Referenz-Appliance gemessen.
Version und Revision werden festgehalten. Es läuft genau der geprüfte Stand.
Modellstände kommen als geprüfte Pakete auf die Appliance, auch ohne Internetzugang.
Die Vermittlungsschicht ordnet jede Aufgabe dem passenden Modell zu und protokolliert den Aufruf.
Eine neue Modellversion ersetzt den alten Stand erst, nachdem sie denselben Weg durchlaufen hat. Ein automatisches Nachladen zur Laufzeit gibt es nicht.
Warum lokale Modelle
Die Gewichte liegen offen, die Versionen sind festgeschrieben, und die Rechnung hängt nicht an der Zahl Ihrer Anfragen.
Alle Modelle laufen auf der Appliance in Ihrem Haus. Ohne externe Modell-API verlässt keine Eingabe und kein Dokument Ihr Netz.
Jede Modellversion ist festgeschrieben und geprüft ausgeliefert. Was heute antwortet, antwortet morgen genauso, bis Sie ein Update freigeben.
Ein fester monatlicher Preis statt Abrechnung je Token. Intensive Nutzung macht die Plattform nicht teurer.
Im Air-Gap-Betrieb arbeitet die Plattform vollständig ohne Internetverbindung. Updates kommen als geprüfte Offline-Pakete.
Ein Zugang, mehrere Modelle
Anwendungen sprechen eine stabile Schnittstelle an. Dahinter ordnet die Vermittlungsschicht jede Aufgabe dem festgeschriebenen Modell zu. Chat, Suche, Nachsortierung und Schutzprüfung laufen getrennt, aber auf derselben Appliance.
Stabile SchnittstelleZuordnung konfiguriertJe Anfrage protokolliert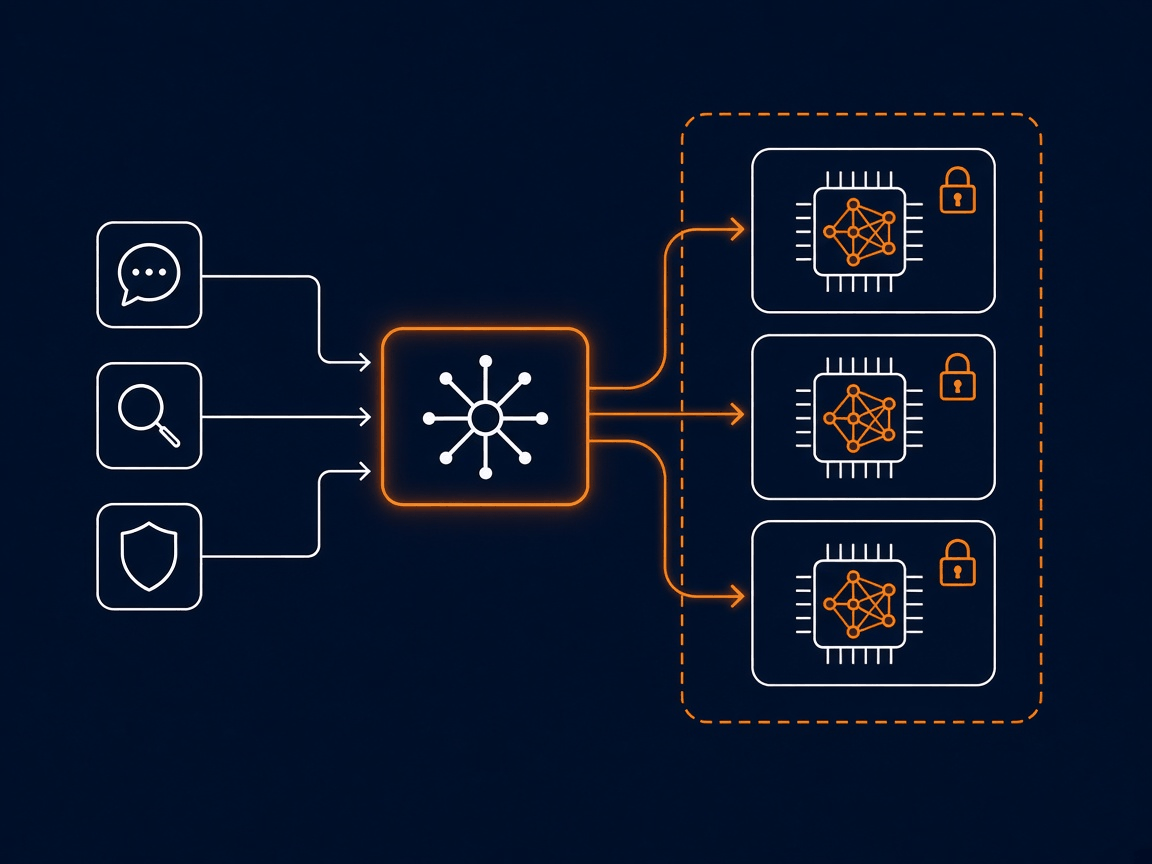
Modelle auf der Appliance
Jedes Modell hat eine klar umrissene Aufgabe und eine Lizenz, die kommerzielle Nutzung erlaubt. Alle Modelle liegen auf der Appliance in Ihrem Haus.
| Modell | Aufgabe | Lizenz |
|---|---|---|
| Qwen3-8B | Chat und Schlussfolgern im Profil Appliance/Standard; zusätzlich Umformulierung und Klassifikation. | Apache-2.0 |
| Qwen3-32B (FP8) | Chat im Qualitätsprofil: höhere Antwortqualität bei weniger gleichzeitigen Nutzern. Das Profil geben wir gemeinsam für Ihre Installation frei. | Apache-2.0 |
| BGE-M3 | Einbettungen für die Vektorsuche im Hybrid-Index. | MIT |
| BGE Reranker v2-M3 | Lokale Nachsortierung der Fundstellen, bevor eine Antwort entsteht. | MIT |
| Qwen3-0.6B (GGUF) | Schutzprüfungen und kurze Klassifikation als eigener CPU-Prozess neben dem Chatmodell. | Apache-2.0 |
| Weitere offene Modelle | Zum Beispiel europäische Modelle für Ausschreibungen: Lizenz und Qualität prüfen wir und nehmen das Modell in Ihr Profil auf. | je Modell |
Jedes Modell ist auf der Referenz-Appliance qualifiziert, gemessen und als geprüftes Paket ausgeliefert.Welches Profil in Ihrer Installation aktiv ist, geben wir gemeinsam frei; die Zuordnung von Aufgabe zu Modell bleibt dokumentiert.Lizenz, Qualität und Aufwand weiterer offener Modelle bestätigen wir im Angebot.Die konkrete Modellausstattung hängt vom gewählten Profil ab. Welche Modelle auf Ihrer Appliance liegen, halten wir im Angebot fest.
Profile und Aufgabenklassen
Die Zuordnung von Aufgabe zu Modell ist konfiguriert und je Anfrage nachvollziehbar. Welches Profil in Ihrer Installation arbeitet, entscheidet, wie viele Personen gleichzeitig antworten lassen.
| Profil | Modell im Chat | Worauf es ausgelegt ist |
|---|---|---|
| Profil Appliance/Standard | Qwen3-8B | Chat und Schlussfolgern für viele gleichzeitige Nutzer. Dieses Profil läuft auf der Referenz-Appliance. |
| Qualitätsprofil | Qwen3-32B in FP8-Quantisierung | Höhere Antwortqualität für weniger gleichzeitige Nutzer. Welches Profil passt, klären wir im Angebot. |
Im Profil Appliance/Standard beantwortet Qwen3-8B Chat und Schlussfolgern, mit Belegen aus Ihren Quellen.
BGE-M3 und der BGE-Reranker tragen Vektorsuche und Nachsortierung der Fundstellen im Hybrid-Index.
Ein eigener CPU-Prozess prüft Eingaben getrennt vom Chatmodell, ohne Rechenzeit auf der GPU zu binden.
Chat, Schlussfolgern, Klassifikation, Umformulierung und Schutzprüfung werden getrennt geführt. Modell und Version werden je Anfrage protokolliert.
Weitere Modelle mit offenen Gewichten nehmen wir nach Lizenz- und Qualitätsprüfung in Ihr Profil auf, darunter europäische Modelle für Ausschreibungen.
Auch Aufgaben wie Transkription und Übersetzung laufen auf derselben Appliance. Es gibt keinen Weg zu einem externen Dienst.
Ein abgestimmter Modellsatz trägt Antwort, Suche, Nachsortierung und Schutzprüfung. Welche Modelle auf Ihrer Appliance liegen, halten wir im Angebot fest.
Die Hardware
Private Spark liefert die Plattform auf einer kompakten Recheneinheit, die in Ihr Haus zieht. Ein eigenes Rechenzentrum brauchen Sie dafür nicht.
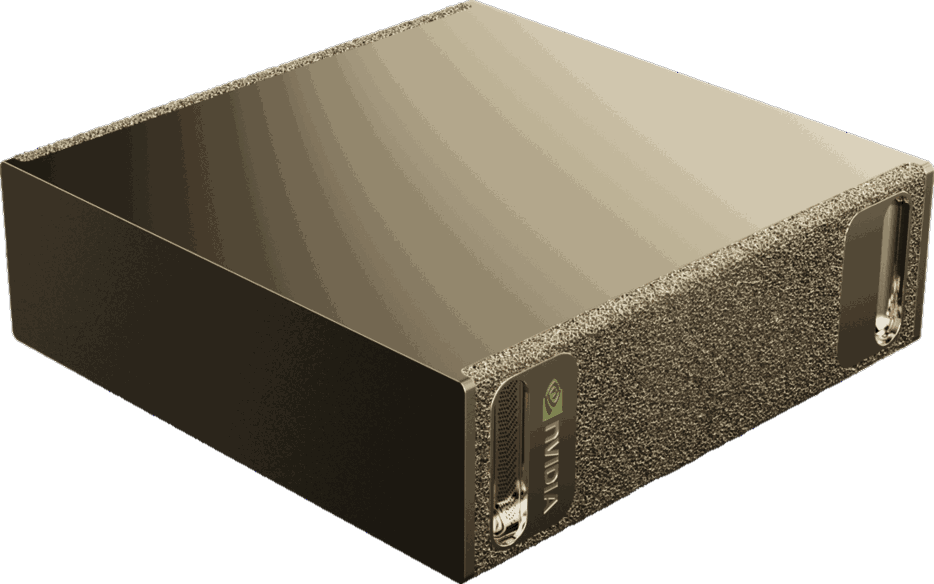 NVIDIA GB10 (Grace Blackwell) mit 128 GB gemeinsamem Speicher für CPU und GPU, genug für Chatmodell, Einbettungen und Nachsortierung gleichzeitig.Kompaktes Gerät für Büro oder Serverraum. Der Anschluss erfolgt in Ihrem Netz, hinter Ihrer Firewall.Für höhere Anforderungen oder vollständig getrennte Netze dimensionieren wir Air-Gap Enterprise nach Angebot.
Häufige Fragen
Im Profil Appliance/Standard ist das Qwen3-8B, ein Modell mit offenen Gewichten unter Apache-2.0-Lizenz. Das Qualitätsprofil setzt auf Qwen3-32B in FP8-Quantisierung. Welche Modelle auf Ihrer Appliance liegen, hängt vom Profil ab und wird im Angebot festgehalten.
Nein. Die Modelle laufen als festgeschriebene Versionen und werden mit Ihren Inhalten nicht nachtrainiert. Was die Plattform aus Ihren Dokumenten lernt, liegt als belegtes Wissen in Ihrer Wissensschicht, nicht in Modellgewichten; dieses Wissen ist prüfbar und löschbar.
Nein. Alle Modelle liegen vollständig auf der Appliance. Im Air-Gap-Betrieb arbeitet die Plattform ohne jede Internetverbindung; Updates kommen als geprüfte Offline-Pakete.
Nichts zusätzlich. Es gibt keine Abrechnung je Token: Sie zahlen einen festen monatlichen Preis für die Appliance, unabhängig davon, wie intensiv Ihr Team arbeitet.
Als geprüfte Pakete. Eine neue Version durchläuft dieselbe Qualifizierung wie das erste Modell, wird festgeschrieben und ersetzt den alten Stand erst nach der Auslieferung. Ein automatisches Nachladen aus dem Internet gibt es nicht.
Auf Private Spark und Air-Gap Enterprise bewusst nicht: Dort gibt es keinen Weg zu einer externen Modell-API. Wer ein betriebenes Angebot bevorzugt, findet mit European On Demand ein eigenes Betriebsmodell; beides bleibt strikt getrennt.
Lokale Modelle
Aus dieser Zahl und Ihren Anforderungen an die Daten ergibt sich, welches Modellprofil auf Ihre Appliance gehört. Sagen Sie uns beides, dann rechnen wir Ihnen Profil und Kosten aus.